从 3nm GAAFET 到 CoWoS-L 异构集成:晶圆键合洁净度、热应力与封装用胶失效解析
峻茂从晶圆前道到系统级散热与光互连,逐段拆解胶粘剂在背面供电、硅通孔、HBM4 多层堆叠、千瓦级液冷与共封装光学中的工程方法论
摘要 (Abstract)
在高算力 AI 芯片的量产导入阶段,限制综合良率的往往不再是单一光刻工序,而是跨工艺段的界面失效,尤其是封装用胶与界面材料。3nm 与 2nm 世代的 GAAFET 纳米片晶体管把沟道厚度压缩到数纳米级,随后通过背面供电(BSPDN)、硅通孔(TSV)、铜对铜混合键合(Hybrid Bonding)、CoWoS-L 局部硅互连以及 HBM4 多层堆叠,在同一个封装体内完成高密度异构集成。整条制造链路跨越晶圆厂前道、中道晶圆级加工与后道高阶封测,晶圆减薄用临时键合胶、高温制程保护与掩膜胶、毛细底部填充胶(CUF)、模塑底部填充(MR-MUF)、芯片级导热界面胶(TIM1)以及光学耦合胶,必须在高温真空、等离子体轰击、亚纳米洁净度要求与高频热机械剪切下维持界面稳定。
峻茂新材料(SCITEO)在配合晶圆厂工艺整合(PIE)与封测产线做失效分析(FA)时发现,许多中后道工序暴露出的微凸块开裂、键合空洞、超声扫描(C-SAM)分层或算力模组服役期热阻飙升,根源往往在前道减薄翘曲控制、解键合残胶清洗或材料热膨胀系数(CTE)与模量的失配。本文按照从晶圆前道加工到系统级散热与光互连的产线顺序,逐段梳理先进制程与先进封装中核心胶粘剂的工艺窗口、关键理化指标及产线选型逻辑。
核心参数对比
下表把峻茂新材料半导体制程用胶与行业常规辅助胶放在同一口径下对比,最后一列可以直接当作评审时的复核清单:
| 参数 | 峻茂方案 | 行业常规 | 测试标准 |
|---|---|---|---|
| 适用工艺节点 | 3nm GAAFET / CoWoS-L | 28nm 及以上 | 不适用 |
| 极端制程耐温 | 300-500 °C | 150-200 °C | TGA/长期热老化 |
| 封装集成规模 | 5.5 倍掩膜版(已量产) | 1-2 倍掩膜版 | 不适用 |
| Underfill Tg | 100-160 °C | 80-120 °C | DMA |
| Underfill CTE | <30 ppm/°C(最低 13 ppm/°C) | 50-80 ppm/°C | TMA |
| TIM1 导热系数 | 20-40 W/m·K | 1-3 W/m·K | ASTM D5470 |
| 芯片粘接剪切强度 | 30 MPa | 5-10 MPa | GB/T 7124 |
| 芯片导电胶剪切强度 | 19 MPa | 5-10 MPa | GB/T 7124 |
| 体积电阻率 | >10¹⁴ Ω·cm | 10¹²-10¹³ Ω·cm | ASTM D257 |
| TIM1 CTE | <20 ppm/°C | >50 ppm/°C | TMA |
| 可迁移离子含量 | ≤10 ppm(Na⁺/Cl⁻) | 30-100 ppm | IC 离子色谱 |
晶圆前道制程 (FEOL):3nm GAAFET、背面供电与高深宽比刻蚀
前道制程不仅决定了晶体管的本征电学特性,也直接划定了晶圆临时键合胶、刻蚀保护胶及制程遮蔽胶的工艺窗口边界。进入 3nm 与 2nm 节点后, GAAFET 环绕栅极纳米片、EUV 多重曝光、高深宽比反应离子刻蚀与背面供电网络(BSPDN)相互叠加,晶圆在真空腔体内的驻留时间显著拉长,局部瞬态热流与等离子体自由基侵蚀同步加剧。在产线异常排查中,不少最初被归咎于机台漂移的套刻超差或静电卡盘(ESC)吸附报警,最终溯源都指向制程辅助胶在高温真空下的微量放气、软化蠕变或边缘崩裂。
GAAFET 纳米片释放、CFET 垂直堆叠
节点从 5nm 走向 3nm 与 2nm 时, FinFET 的三面栅极对沟道的静电控制逐渐失效,短沟道效应与漏电流(Leakage Current)同步抬升。行业转向 GAAFET(Gate-All-Around,环绕栅极晶体管)与 Nanosheet(纳米片)架构,让栅极从四面包裹沟道,把控制权重新收回。EUV 极紫外光刻是这套架构的使能工艺,但它同时把高能等离子体轰击与局部热负荷压到晶圆表面;这些负荷沿厚度方向传导到临时键合界面,成为后续良率波动的来源之一。

栅极控制权的下一站已经写进路线图。互补场效应晶体管(CFET, Complementary FET)把 NMOS 与 PMOS 垂直堆叠,让单元面积再收缩一档:英特尔在最新一届 VLSI 研讨会上给出 45 nm 栅极间距、带 PowerVia 与背面直接接触的单片 CFET 反相器,三星以 42 nm 栅极间距实现三层堆叠纳米片沟道,台积电则在 IEDM 上把单片 CFET 环振做到 48 nm 栅极间距以内,并演示了当时面积最小的 6T SRAM。器件一旦垂直化,晶圆表面的纳米形貌预算与键合界面的洁净度预算都要再收窄。
把镜头拉近到 GAAFET 的沟道,这颗器件其实是一叠被精确释放的纳米片:先在硅衬底上外延生长 Si/SiGe 超晶格,再用选择性刻蚀掏空 SiGe 牺牲层,让几纳米厚的硅片逐层悬空,最后由栅极金属四面包裹。决定良率的往往不是外延本身,而是选择性刻蚀的选择比与界面洁净度:SiGe 回刻要在不伤及硅沟道的前提下刻蚀到精确深度,再由原子层沉积填入低介电常数的内墙介质(SiBCN / SiOCN),把随后的栅极金属与源漏隔开;源漏一侧则靠 SiGe(PMOS)或 Si:P(NMOS)外延提供应变与低阻接触。峻茂在掩膜与临时保护胶上按这一段工艺窗口做配套:在 300-500 °C 的退火与沉积窗口内守住图形边缘与厚度均匀性,剥离后不留残胶,避免把有机残留带进后续的释放与键合界面。对材料而言,这一步的约束不在耐温上限,而在选择比与洁净度的耦合:刻蚀残留、颗粒与金属离子会一起放大成器件级失效。
背面供电 BSPDN
2nm 以下节点,供电互连与信号互连在有限的正面金属层内相互挤压,线路拥塞与电压降(IR Drop)升级为设计约束。背面供电(Backside Power Delivery Network, BSPDN)把供电网络整体移到晶圆背面,让正面金属层全部释放给信号布线。
英特尔 PowerVia 随 Intel 18A 进入量产,并在最新一届 VLSI 研讨会上给出了迄今最完整的量化账本:布线面积最高压缩 11%,最坏情况动态电压跌落压到约 1/10,换来最高 6% 的频率提升,或超过 15% 的动态功耗下降。接续的 Intel 18A-P 已进入风险生产,同功耗下性能提升超过 9%、同性能下功耗降低超过 18%,材料与设计协同把热阻压低 20%-40%;面向 3DIC 的 18A-PT 还把硅通孔、裸片对裸片互连与业界领先节距的混合键合界面(HBI)整合进基础裸片,裸片间带宽密度最高提升至 9 倍,风险量产目标已经写入路线图。台积电在 A16 节点导入超级供电轨(Super Power Rail, SPR),以背面对源漏的直接接触保住 N2P 的栅极密度,同等功耗下速度提升 8%-10%、同等速度下功耗降低 15%-20%、芯片密度提升约 1.10 倍,量产窗口已经锁定;第二代背面供电轨落在基于 A14 平台的 A12 上,与 A13 同期进入量产。
这条路线对辅助材料提出新约束。BSPDN 工艺链包含晶圆对晶圆键合、超薄化减薄、背面对准、纳米级硅通孔(nTSV)刻蚀与背面金属化;晶圆减薄后刚性急剧下降,必须依赖临时键合层提供机械支撑,而背面对准偏差会直接推高接触电阻甚至造成开路。键合层的 CTE 与模量是否与硅匹配,直接决定减薄后晶圆的翘曲量级,翘曲又会在后续光刻与键合工序中放大为套刻误差。
CVD/PVD、离子注入与快速热处理
在形成晶体管源极/漏极与沉积绝缘介质层时,广泛采用化学气相沉积(CVD)与物理气相沉积(PVD);离子注入之后的快速热处理(RTP)需要极高温度,用于激活掺杂原子并修复晶格损伤。
这类晶圆级高温制程中,晶圆的临时固定、掩膜遮蔽与探针卡制造都对辅助材料的耐热极限构成直接约束。传统耐高温胶在此温度下会迅速分解、挥发并残留碳化物,制造致命的脱气污染;行业以 ASTM E595 的总质量损失(TML)与可凝挥发物(CVCM)量化这一风险, CVCM 越低,腔体与探针被污染的概率越小。头部晶圆厂在前端制程与高温老化测试中采用峻茂新材料芯片制程耐高温胶(耐温 300-500 °C),看重的是它在极端热冲击之后仍能同时守住结构完整性与绝缘、导电特性。但是这类耐温、TML 与 CVCM 指标并不是标准品目录里的一行数字,而是随客户腔体气氛、升温速率和驻留时间定制出来的配方窗口,这也是峻茂作为研发型供应商更愿意提前介入工艺定义阶段的原因。
高深宽比刻蚀与等离子体轰击
在 GAAFET 的纳米片释放、深槽隔离与大马士革沟槽刻蚀中,工程师要面对极端的深宽比依赖性刻蚀(ARDE)。洞越深,刻蚀速率越慢,底部甚至会出现轮廓变形或微沟槽(Micro-trenching),高能等离子体同时带来剧烈的局部温升。深宽比越高,掩膜胶越要在离子轰击与温升叠加的条件下同时守住图形边缘与厚度均匀性,任何软化流动都会把刻蚀轮廓直接写坏;掩膜材料因此把瞬态耐温、抗等离子体刻蚀与低挥发三项并列为核心指标,而不是只报一个长期耐温值。
中道制程 (MEOL):TSV、混合键合与亚纳米洁净度
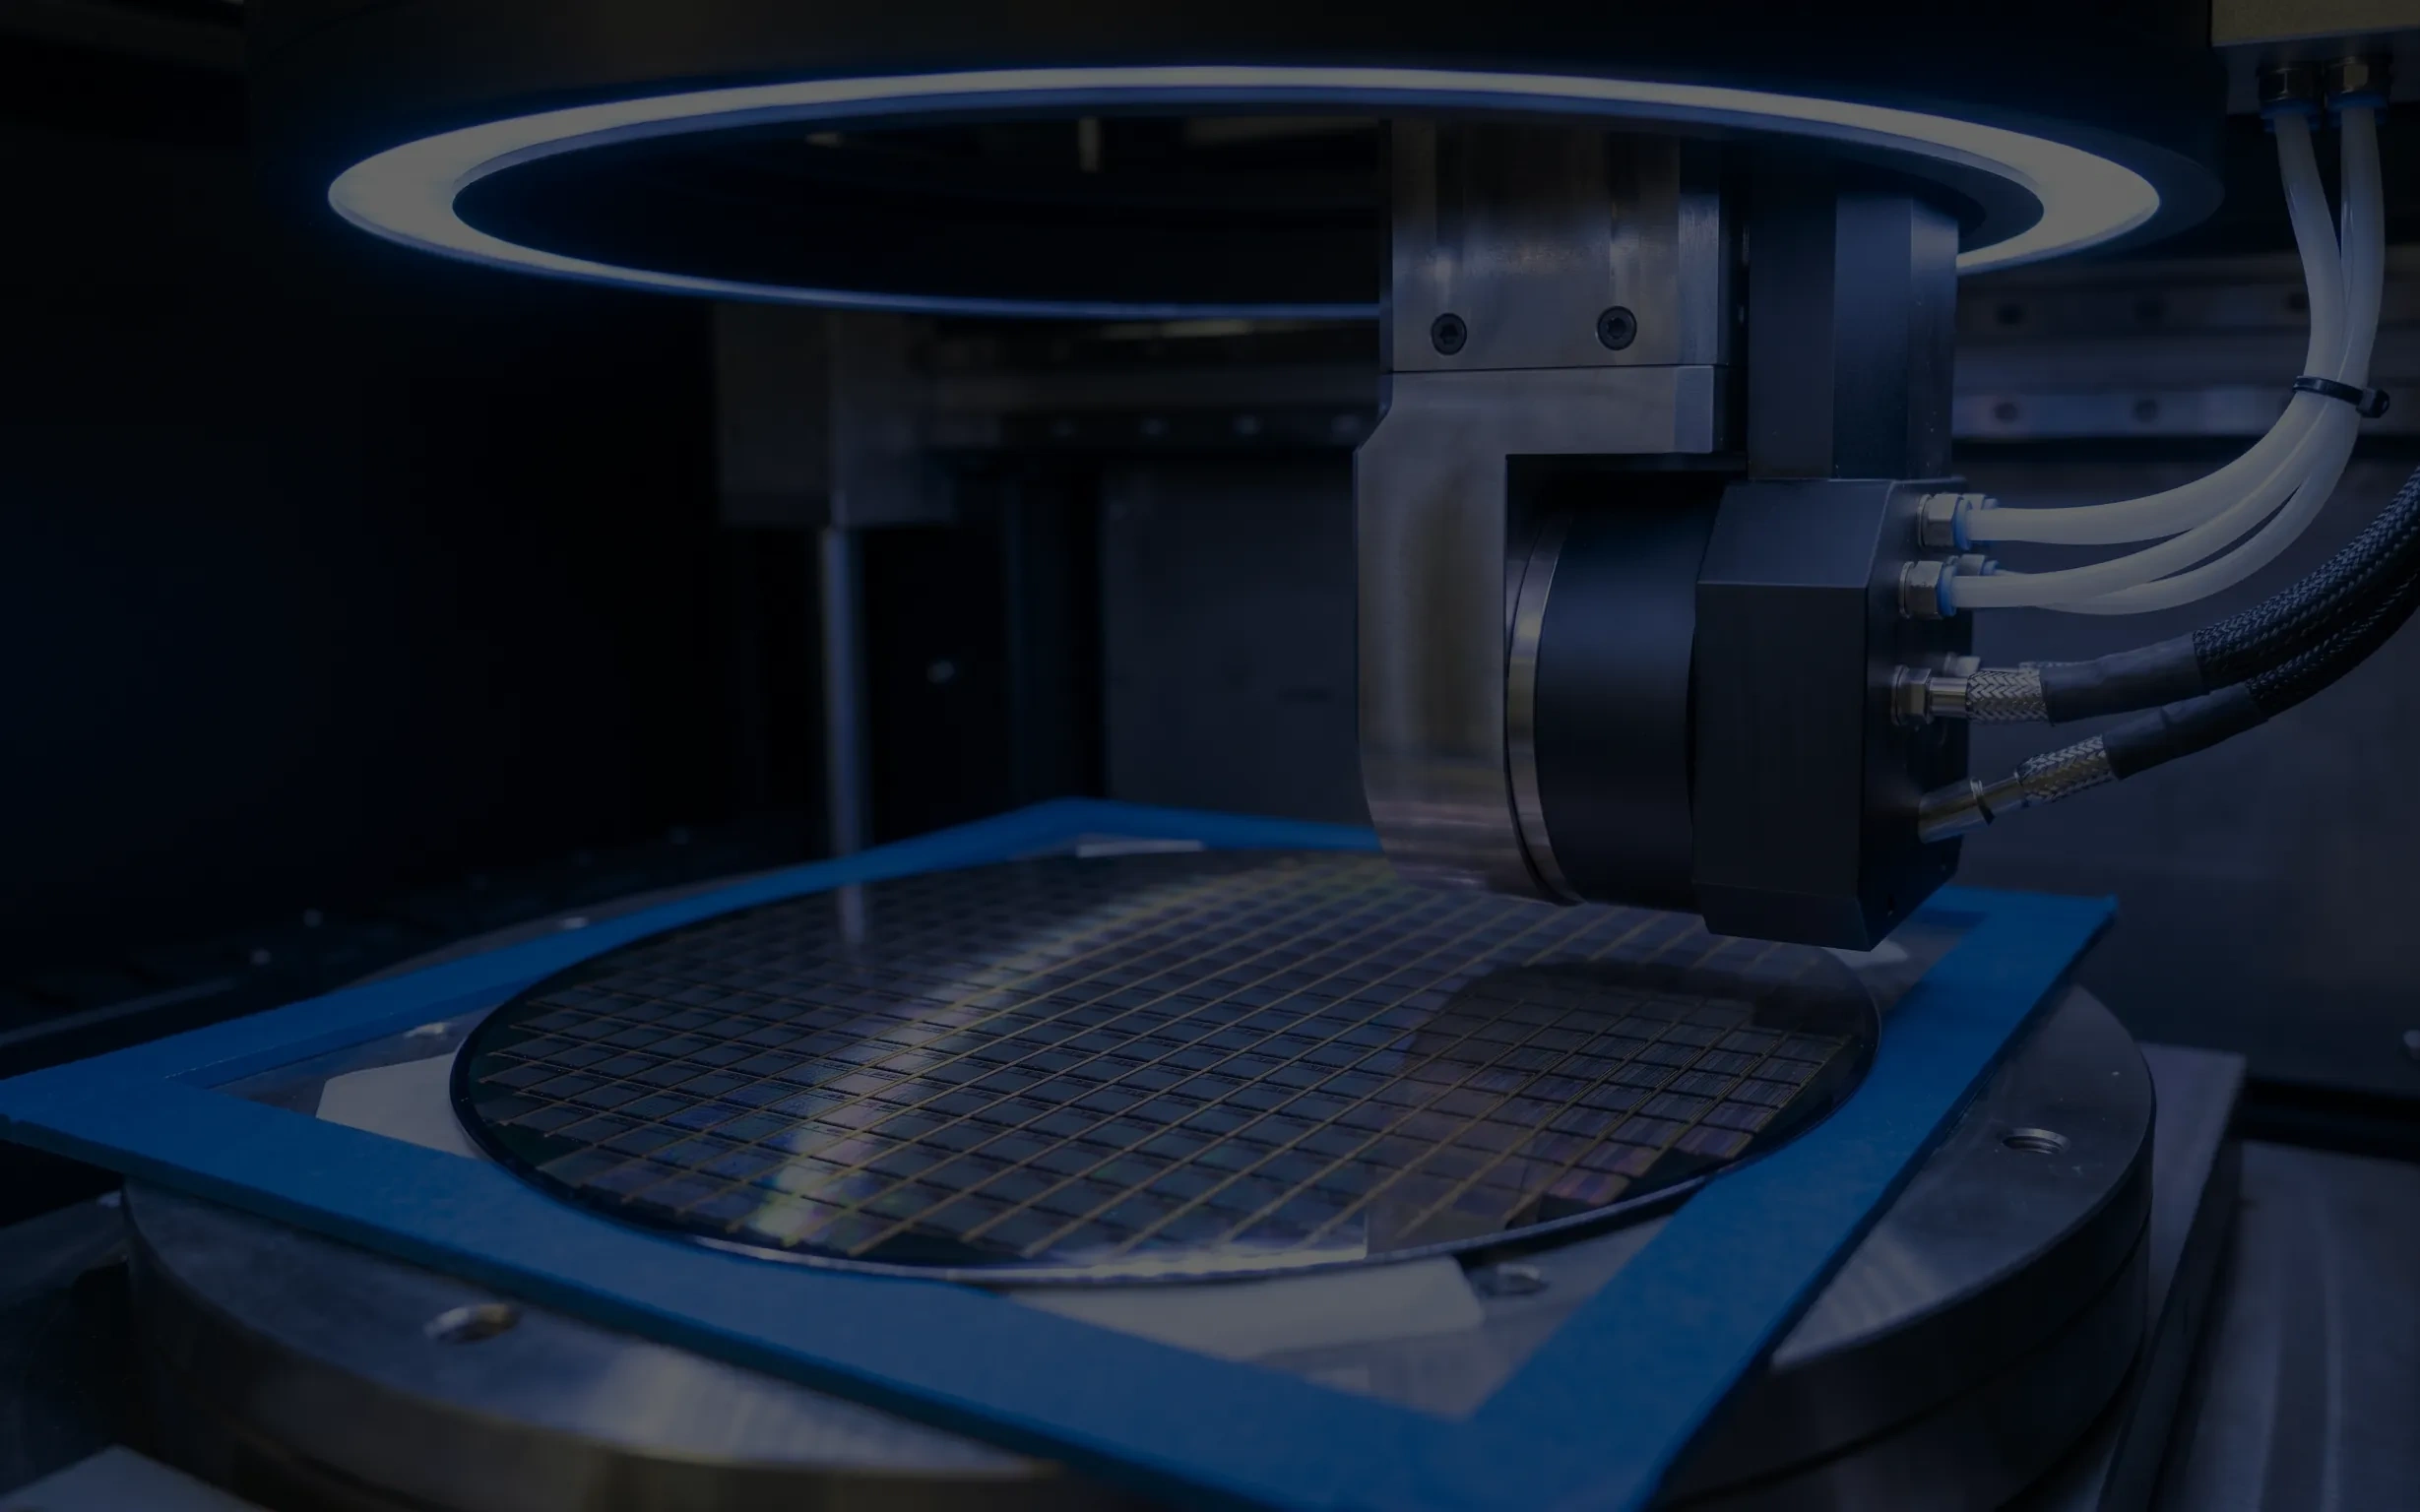
当单一芯片的面积逼近光刻掩膜版极限(Reticle Limit,约 850 mm²)时,良率随面积呈非线性下降,行业因此转向 Chiplet 拆分与先进封装。中道制程承担垂直互连:TSV 打通硅片并填充铜,混合键合把铜与氧化物在原子尺度直接连接。其良率不由设备精度单独决定,而由界面洁净度、表面平坦度与残留物化学身份共同决定。
TSV(硅通孔)与硅中介层
要在硅中介层上实现 GPU 与 HBM 的高带宽垂直互连,必须打穿硅片并填充铜。TSV 刻蚀最常见的问题是侧壁呈扇贝纹,直接后果是后续绝缘层与阻挡层沉积不均,埋下漏电隐患。在后续加热工艺中,铜柱膨胀会挤压周围硅片形成微裂纹与应力集中区,这是中道良率损失的核心成因之一。
封装互连的代际演进,本质上是一条连接点越做越小、越做越密的曲线:
| 互连代际 | 典型节距 | 物理瓶颈 |
|---|---|---|
| 引线键合 Wire Bonding | ≈100 μm | 带宽低、延迟高,主要留在成本敏感器件 |
| 倒装芯片 Flip Chip | 100-150 μm | 焊球尺寸受限,密度提升乏力 |
| 微凸块 Micro-bump | 40 μm 向 10 μm 收敛 | 焊料体积过小后短路、开路与装配良率急剧恶化 |
| 混合键合 Hybrid Bonding | 量产 6 μm(研发已演示亚微米级) | 亚纳米洁净度、表面粗糙度 0.2 nm 与亚百纳米对准 |
混合键合(Hybrid Bonding)的界面物理
主流互连至今仍依赖微凸块,但其节距极限停留在数十微米量级。要实现更高密度的 3D 堆叠,例如 HBM 内部存储颗粒的堆叠、或逻辑芯片上的 SRAM 堆叠,行业正在向无凸块的铜对铜混合键合演进。台积电把 SoIC 的键合节距从 9 μm 压到 6 μm,路线图直指 4.5 μm;英特尔的 Foveros Direct 已随 Clearwater Forest 服务器处理器进入量产, AMD 自第一代 3D V-Cache 起就在量产中使用这套工艺。密度收益是数量级的:面对面混合键合能提供约每平方毫米 14000 个信号连接,而基于硅通孔的面对面到背面堆叠约为每平方毫米 1500 个。
这条路对界面的要求近乎苛刻。晶圆表面需达到原子级平整度,抛光后介质表面的起伏控制在 0.2 nm 量级,铜焊盘略低于介质面几个纳米,室温下依靠范德华力贴合,再经 200-300 °C 退火让铜膨胀闭合间隙。对准精度要进入亚百纳米量级,颗粒污染近乎为零:一颗百纳米直径的颗粒,就足以让一整片区域无法成键。工艺路线上,晶圆对晶圆键合在晶圆尺度一次性对准,节距最细、吞吐最高,代价是两片晶圆的裸片尺寸必须一致且不良裸片一并键合, imec 与 EV Group 已在 ECTC 上演示 200 nm 晶圆对晶圆节距、键合后套刻优于 40 nm;裸片对晶圆键合允许先测后贴、可混搭不同尺寸与节点,但每颗裸片都要单独拾取与对准, CEA-Leti 在 ECTC 上展示的最好成绩是 1 μm,设备端则以每小时约 1600 至 2000 颗的节拍运转,量产档位的贴装精度正在向 50 nm 收敛。
研究侧的节距标杆也在往前挪。应用材料在最新一届 ECTC 上首次演示 450 nm 节距的铜-铜混合键合,在 2000 万条互连上做到 98% 良率,并把界面处的一层碳富集薄层与铜晶粒取向指认为纳米级开口缺陷的来源。这条结果把混合键合的良率控制从颗粒计数推进到了界面化学:真正决定开口的,是残留物的成分与铜晶粒的取向,而不只是颗粒的数量。
这也解释了为什么临时键合胶与掩膜胶必须做到无残胶剥离:任何微小有机物残留都会在退火膨胀后形成宏观空洞,导致上下层芯片断路报废,而残留物的化学身份往往要等到退火之后才以失效形式暴露。在存储侧, JEDEC 已将高带宽内存封装厚度上限从 720 μm 放宽至 775 μm,微凸块方案重新获得厚度余量。SK 海力士在最新一届 Hot Chips 上给出了最新口径:混合键合赶不上 HBM4E,最早顺延至 HBM5 世代;当前 12 层堆叠量产、16 层(48 GB/立方体)进入客户验证,核心裸片压到约 50 μm,层间间隙较 12 层减半,热压键合(TCB)与批量回流模塑底填(MR-MUF)继续承担主干工艺;而引脚速率从初代 HBM 的 1 Gbps 提到 HBM4 的 8 Gbps JEDEC 基线、再往 HBM4E 的 16 Gbps 演进之后,堆叠的热负载已是前几代的 2.2 倍,留给材料的热预算反而更薄。散热的压力因此从封装外部转到了封装内部:SK 海力士的 iHBM 把绝缘导热块嵌入 D2D 物理层,官方口径是热阻下降逾三成,三星的 HPB 走独立散热柱通道,两家均计划自 HBM5 起量产;其路线图还显示, 20 层堆叠若改用混合键合,核心裸片可加厚最多 24%、热阻较 MR-MUF 下降约 35%、凸点节距压到 18 μm 以下,行业已开始讨论把封装厚度预算放宽到 825-900 μm 以容纳 20 层堆叠。但亚纳米洁净度与亚百纳米对准这两项硬约束,已提前写进下一代工艺清单。
CMP 形貌漂移、排队时间(Q-time)与 KGD 筛选
在产线实际运行中,混合键合良率往往受制于 CMP 铜凹陷漂移、工序排队时间(Queue Time)与已知良品裸片(KGD)筛选三者的耦合。CMP 抛光液与抛光垫状态随时间轻微偏移,就会导致铜焊盘凹陷过大(退火后无法接触开路)或凹陷过小(铜膨胀顶起介质层导致周边氧化层开裂);抛光激活后的晶圆若在空气中停留超过规定的 Q-time,介质表面过度吸附水分子会导致退火时水汽聚集鼓泡,铜表面也会重新长出氧化层。此外, W2 W 键合虽然节距小、吞吐高,但无法剔除单颗失效裸片; D2 W 键合支持先测试筛选 KGD 再逐颗贴装,但每小时 1600 至 2000 颗的高速拾取贴装要把对准精度压在 50-100 nm 以内,任何由减薄残余应力引起的裸片微翘曲都会直接拉低边缘键合良率。
回到材料侧, HBM4 与 HBM4E 世代仍由 TCB 与 MR-MUF/NCF 承担主干工艺,真正的窗口收窄发生在 10 μm 级层间间隙与 50 μm 薄片的共同约束下:底填必须在超窄间隙中无空洞填充,同时把翘曲与剪切应力压在封装厚度预算之内。SK 海力士的 iHBM 与三星的 HPB 把独立导热通道嵌入封装内部,说明热预算正在从外部冷板向堆叠内部转移;待 20 层世代导入混合键合,核心裸片可加厚、堆叠热阻继续下探,但对亚纳米洁净度与亚百纳米对准的要求只会更严。峻茂新材料在临时键合胶、切割保护胶与超窄间隙底填胶的配方设计上,正是围绕零有机残留、极低可迁移离子与 50 μm 薄片低翘曲控制做前瞻卡位。
后道制程与封装 (BEOL):RC 延迟到 CoWoS-L 与面板级封装
后道制程解决的是信号传输效率与结构完整性的矛盾。线宽缩小推高 RC 延迟, low-k 介质牺牲机械强度;把昂贵的 Chiplet 装到有机基板上又引入 CTE 失配。封装尺寸越大,界面数量越多,留给每个界面的应力预算越薄。底部填充与导热界面材料之所以从辅料升级为结构材料,原因就在这里。
RC 延迟与 CMP 抛光
线宽缩小后铜导线截面积减小、电阻(R)飙升,导线间距拉近又使寄生电容(C)增加, RC 延迟已成为限制 AI 芯片主频提升的主要物理瓶颈;为压低电容,行业引入内部充满微孔、机械强度极低的 low-k 材料。铜互连本身的电阻瓶颈同时在逼出新方案:英特尔在 VLSI 研讨会上演示的减材钌(Subtractive Ruthenium)加气隙(Air Gap)集成,把互连电容再压低约 35%,为金属节距继续收缩留出余量。
CMP 抛光阶段,脆弱的 low-k 材料易出现微裂纹、剥离或铜焊盘碟形凹陷(dishing)与介质层侵蚀。对依靠临时键合固定超薄晶圆的工艺而言,研磨液冲刷与下压剪切同样考验胶层的抗剥离能力:键合强度不足会在抛光中途造成晶圆滑移,残胶则会在后续清洗中转化为颗粒缺陷。
CTE 失配与焊点断裂
把昂贵的 Chiplet 组装到有机基板上,是整个封装良率博弈的核心环节。硅的 CTE 约 2.6 ppm/°C,玻纤树脂基板高出数倍(约 15-20 ppm/°C),封装体经 260 °C 无铅回流焊并冷却至室温时两者收缩步调严重不一致,累积出巨大剪切应力,芯片边缘的微凸块会被直接撕裂。
底部填充胶的毛细流变学
对抗这种撕裂,必须向芯片与基板之间仅有几十微米的缝隙中注入底部填充胶,材料需要极高的毛细流动性(Capillary Flow),并在凸块阵列中做到零气泡空洞。峻茂新材料的先进底填材料固化后形成高 Tg(100-160 °C,按 DMA 测试)与低 CTE(<30 ppm/°C,最低 13 ppm/°C,按 TMA 测试)的三维网状结构,把原本集中在微凸块上的剪切应力摊到整个封装界面,成倍提升 AI 芯片的板级热循环(TCoB)寿命。评审时 Tg 与 CTE 必须成对核对,并同步确认固化收缩率、可迁移离子含量与 CVCM:固化收缩率决定残余应力是否会把脆弱的 low-k 结构拉开,可迁移离子含量决定湿热偏压下绝缘性能能维持多久,而峻茂底填体系的 CVCM 控制在 0.02% 以下,可降低真空与回流环境下的腔体污染风险。
CoWoS-L 与面板级封装
先进封装平台按中介层形态分为硅中介层(CoWoS-S)、重布线层(CoWoS-R)与局部硅互连(CoWoS-L)三条路线,分别对应布线密度优先、成本优先与超大尺寸优先三类设计取向。旗舰 AI 加速器普遍采用局部硅互连方案,用局域硅桥把多颗逻辑裸片拼在同一封装内,可挂载的 HBM 堆叠数量与单 GPU 显存带宽同步抬升;桥接结构与中介层、有机基板叠加,界面数量成倍增长, CTE 失配的累积量随之放大。台积电的尺寸路线给出了这条约束的量化边界:3.5 倍掩膜版的 CoWoS-L 已经量产, 5.5 倍掩膜版完成认证并进入量产, 14 倍掩膜版已在路线图上,可容纳约 10 颗大型计算裸片与 20 个 HBM 堆叠,其后继续向更大的尺寸推进,并与 40 倍掩膜版的系统级晶圆(SoW-X)并行推进。
再往前一步是封装形态本身的变化。面板级封装(Panel-Level Packaging)把圆形晶圆换成矩形面板,面积利用率显著提升、单位面积成本同步压缩;玻璃芯基板把传统有机芯层替换为可调 CTE 的玻璃,并靠玻璃通孔(TGV)打通垂直互连与散热通道,机械刚性与介质损耗同时改善。两者的共同结果,是把更多界面压缩到更大的封装体内,界面材料的润湿性、附着力与应力缓冲能力因此成为一阶变量。
高算力、液冷与光互连
算力攀升带来急剧膨胀的热密度。单颗高端 AI 芯片功耗已进入千瓦级,整机柜功耗抬升到需要全液冷的量级,散热与互连同时向封装内部收缩。
界面热阻与 TIM1 泵出
热量无法迅速传导到均温板或冷板时,芯片就会触发热节流,算力随之骤降。裸片(Die)与散热顶盖(Lid)之间的 TIM1 层是打通热流通道的关键瓶颈,在高频热胀冷缩的泵出效应(Pump-out)下,普通导热材料极易粉化剥离。
为应对高热流密度载荷,峻茂新材料芯片粘接导热胶通过高密度导热粉体级配与高分子界面偶联技术,在维持优异流变性的同时实现极低的界面热阻,并达到 20-40 W/m·K 的导热系数(按 ASTM D5470 测试)、30 MPa 的剪切强度(按 GB/T 7124 测试)与 <20 ppm/°C 的 CTE(按 TMA 测试)。这一区间并非随意设定:常规聚合物基 TIM 的导热系数只有 3-6 W/m·K,在 600 W 级模块中单层低导热界面就能贡献约 10 °C 的温升;液态金属类方案能把界面热阻压到 0.01-0.025 °C·cm²/W,却受限于密封与电偶腐蚀风险。泵出抵抗力的关键在基体模量,工程上通常通过交联密度把模量控制在 0.1-2.0 MPa 的窗口内,既守住抗剪切形变的内聚力,又保留贴合粗糙表面的柔顺性。峻茂自有实验室按 ASTM D5470 反复实测发现:同一配方的导热系数会随测试压力与粘接层厚度(BLT)漂移,评审应锁定目标压力与厚度复测界面热阻。
射频前端与精细互连的信号纯净度
在通信基带、射频前端(RF)模块、车载激光雷达、高速光模块内部芯片贴装(COS / COB)以及部分无法承受高温回流焊的系统级封装(SiP)中,传统焊锡工艺常面临连锡短路或热损伤风险。基于渗流理论的峻茂新材料芯片导电胶,通过控制银粉紧密堆积与极低的离子杂质含量,在提供 19 MPa 粘接强度(按 GB/T 7124 测试)的同时构建低阻抗欧姆接触网络,为高频高速信号留出纯净的传输通道。
真正决定这颗材料能否进入毫米波与高速链路的,是导电骨架之外的杂质控制。界面处的可迁移离子(Na⁺、Cl⁻)在湿热偏压下沿电场迁移,会在细间距焊盘之间生长出枝晶;银本身也以离子形态参与电化学迁移。把离子含量压到 10 ppm 以下、并把固化收缩控制在低水平,目的是让接触电阻在温度循环中不过度漂移,因为对 200 Gb/s 级链路而言,焊点界面的阻抗漂移最终会折算成插入损耗与眼图余量,而这份预算是按零点几分贝分配的。这也是导电胶在光模块 COS、射频前端模组、功率模组与 MEMS 封装里持续替代焊料的原因:它把互连从焊接冶金学问题转为分子配方问题,在微型化与异质集成中保住了设计自由度。
AI 训练服务器:HBM4 堆叠与千瓦级液冷的界面闭环
把界面热阻与信号完整性的要求放回整机环境, AI 训练服务器是当下最严苛的验证场。在整机柜架构中,单块 GPU 基板上堆叠的 HBM 与 CoWoS-L 中介层构成多层界面结构, CTE 失配的总量被成倍放大。训练负载在满载与待机之间高频切换时,整个中介层经历剧烈热循环,最先分层的往往是强度不足的芯片粘接界面;而 HBM 通道一旦中断,训练吞吐会立刻明显下滑。
散热侧的演进进一步收紧了材料窗口。GPU 单颗热设计功耗已从 A100 的 400 W 推高到 2.3 kW 量级(Vera Rubin 世代), DGX Rubin NVL72 单机柜在满性能工作点功耗约 227 kW,风冷被完全排除; Rubin 世代实现 100% 液冷,进液温度抬升到 45 °C 的温水区间,用更高的冷板温度换取全年自然冷却。液冷冷板带走顶盖热量,却同时拉大了裸片与顶盖之间的温度梯度, TIM1 泵出效应由此被激化。峻茂新材料以高模量导热界面材料抵抗泵出,并以低 CTE 底填分散堆叠界面的剪切应力,让界面热阻在长期服役中保持稳定。前文提到的封装内独立导热结构,正是在这条热流路径上做的另一手准备;当热量被从堆叠内部提前导出,封装底部的界面材料就不再需要独自扛下全部热预算,选材时也应把这条新热路一并算进去。

共封装光学 CPO:亚微米对准成了新的选材门槛
光互连正在从前面板移进封装。传统可插拔光模块要求电信号沿印制板传输十几厘米才能完成电光转换,当单通道速率提升到 200 Gb/s 量级,高频衰减、介质损耗与信号反射同步恶化,功耗与端口密度同时受限。共封装光学(Co-Packaged Optics, CPO)把硅光子引擎与交换 ASIC 放在同一封装基板上,让电信号在离开芯片后以毫米级路径完成转换。英伟达 Spectrum-X 以太网硅光交换机已进入全面量产,被定义为全球首款量产的 200G/lane CPO 以太网交换系统:SN6810 以单颗 Spectrum-6 ASIC 提供 102.4 Tb/s 交换容量, SN6800 则以 512 个 800G 端口把系统带宽推到 409.6 Tb/s;配合外置激光源方案,激光器数量减少约四分之三、网络功耗效率提升 5 倍、平均中断间隔(MTBI)提升 10 倍。台积电的 COUPE on substrate 也已进入生产,把光引擎直接集成进封装,官方口径是功耗效率提升 2 倍、延迟降低 10 倍。近封装光学(NPO)则凭借可维护性先行落地,华为在最新一届全联接大会上发布昇腾 960 超节点,用 5500 个自研 NPO 光引擎(Hi-ONE,单模块 7.2 Tbit/s)替代原本需要的 48000 颗 800G 可插拔模块,系统功耗下降超过 550 kW,平均无故障运行时间提升一倍,系统可用度达到 99.8%。两条路线并行共存已是客户侧的共识;在 409.6 Tb/s 的系统交换容量下,面板密度与功耗的物理拐点已经出现, CPO 与 NPO 的分工也随之固化。
当光引擎与交换 ASIC 共处同一封装,光路的亚微米对准容差就变成了界面材料的新考核项:固化收缩会直接移动耦合位置,模量过高会把应力传递到光引擎,模量过低则无法在热循环中维持准直。峻茂新材料在光学半导体封装上的低收缩与低模量应力缓冲配方,正是为这类共封装结构预留的技术冗余。
封装路线图演进
基于晶圆代工厂与 OSAT 头部产线的最新设备与基板导入节奏,未来先进封装基板的形态演进正在对界面材料提出更具体的配方调整要求。
桥接结构正在替代整片式中介层。 嵌入式多芯片互连桥已推进到带硅通孔的 EMIB-T 世代。英特尔在 ECTC 上给出的一手数据是:在两倍掩膜版硅面积的封装上实现 36 μm 凸点节距,凸点密度较 Granite Rapids 的 45 μm 提升 65%,验证范围正在向 4.5 倍掩膜版扩展,认证节点已经排定;单条 3 mm × 18 mm 的桥已能把两颗一倍掩膜版裸片以 25 μm 节距连起来,而节距一旦低于 25 μm,限制就会从桥内布线密度转移到凸点成形、贴装精度与装配良率。桥内的硅通孔把供电直接穿过桥体,直流压降较传统 EMIB 降低 68%-80%,桥内 MIM 电容密度达到 500 nF/mm²。四分之一面板级试产件尺寸达到 240 mm × 240 mm,约合 67 个掩膜版面积,翘曲已经与布线密度并列成为一阶约束。封装越大,留给界面的应力预算越薄。
玻璃基板正在走出实验室。 英特尔在 NEPCON Japan 上展出了 78 mm × 77 mm 的全尺寸玻璃芯基板原型:10-2-10 的二十层堆叠结构,玻璃芯厚度 800 μm,凸点节距 45 μm,硅芯片安装面积约 1716 mm²(约两倍掩膜版),并明确表示已解决切割与搬运过程中的微裂纹问题。玻璃的 CTE 更靠近硅、翘曲更小,但表面金属化与精细布线的工艺成熟度仍在爬坡,产业化节奏大概率沿供样、认证、量产的顺序推进。玻璃对界面材料的润湿性与附着力提出了新的要求,低温固化体系也因此获得额外的工程价值。
面板级封装正在改写面积经济学,但尺寸先退一步。 行业规划的载具格式横跨 310 mm × 310 mm、510 mm × 515 mm 与 600 mm × 600 mm,台积电的 CoPoS 先锚定 310 mm × 310 mm 做中试,把 510 mm × 515 mm 留给玻璃芯成熟之后。大面板的诱惑在于单位成本,风险则在翘曲、均匀度与拼接精度,量产的规模化窗口落在未来两到三年内。
量子计算把温区推到了毫开尔文级。 芯片级可扩展光量子计算机与超导路线都对深冷界面提出极端要求:极低温脆化、多材料 CTE 失配与超低放气必须同时成立,这与高温制程对材料的约束形成镜像,考验的是同一套配方平台在温区两端的弹性。
峻茂新材料认为,这些方向未必会在同一时间变成订单,但它们决定了材料平台的配方储备方向。峻茂应用团队会持续跟踪这些前沿工艺,并据此调整耐温、导热与低应力三条产品线的开发优先级。
按工艺段整理的界面材料选型速查
下列对照表把前文机理压缩为可执行的选型口径,供工艺工程师在评审阶段直接核对:
| 工艺段 | 典型失效模式 | 关键指标 | 峻茂对应方向 |
|---|---|---|---|
| 晶圆临时键合与背面减薄 | 高温脱气污染腔体、减薄后翘曲、剥离残胶 | TML/CVCM、耐温上限、CTE 匹配、无残胶剥离 | 芯片制程耐高温胶(300-500 °C) |
| 高深宽比刻蚀掩膜 | 胶层软化流动、图形偏移 | 瞬态耐温、抗等离子体轰击、低挥发 | 芯片制程耐高温胶 |
| TSV 与混合键合 | 颗粒与有机残留导致的成键空洞 | 亚纳米洁净度、可迁移离子含量、剥离残留 | 临时键合与掩膜胶(无残胶剥离) |
| 倒装芯片底部填充 | 空洞、分层、焊点疲劳 | Tg 100-160 °C、CTE <30 ppm/°C、毛细流动性 | 芯片填充封装胶(Underfill) |
| 裸片粘接与导热界面 | TIM1 泵出、界面热阻漂移 | 20-40 W/m·K、30 MPa 剪切、CTE <20 ppm/°C | 芯片粘接导热胶(TIM1) |
| 射频与 SiP 互连 | 连锡短路、热损伤、离子迁移 | 19 MPa 粘接强度、低离子含量、低阻抗 | 芯片导电胶 |
三维异构封装体系
摩尔定律在二维平面的几何微缩逼近原子极限后,算力密度的演进重心已全面转向三维空间的异构集成。伴随器件架构向垂直堆叠与晶圆级尺度扩张,半导体系统的物理瓶颈发生了本质迁移:单晶硅内部的载流子输运已逼近材料与结构的物理边界,而异质材料交界处仅数微米乃至数纳米厚的界面层,正成为支配系统热力学与机械可靠性的决定性区域。
在三维异构封装体系中,每一处相界都是物理场的不连续面。声子在硅、金属与聚合物基体交界处的非弹性散射设定了高热流密度系统的界面热阻基线;高分子交联网络在宽温域下的自由体积演化与粘弹性应力松弛,决定了微细互连结构在交变剪切场中的疲劳寿命;亚纳米尺度的表面自由能与本征化学纯度,则直接左右着原子级键合的成核与生长。当互连节距与键合层厚度进入微纳尺度,体相材料的宏观均值参数不再适用,界面区的分子链取向、多尺度填料渗流拓扑以及奇异应力场的局域耗散,构成了现代微电子封装的底层本构方程。峻茂新材料专注于高端电子界面材料的底层研发,在分子工程与先进制造的交界处,持续探索高性能胶粘剂的技术边界。
本文系峻茂新材料技术原创,未经授权禁止转载。
工艺与可靠性问答
晶圆减薄到几十微米后,为什么翘曲和套刻误差会一起放大?
因为减薄把晶圆的抗弯刚度几乎抽干了。300 mm 晶圆减薄到 50 μm 量级后,刚度按厚度三次方下降,此时晶圆的正反面应力差、临时键合层的固化收缩和残余应力,都会被放大成肉眼可见的翘曲。翘曲本身不致命,致命的是它进了后续光刻、背面对准与键合工序:设备是照着理想平面标定的,晶圆一旦不平,套刻误差、接触电阻和键合空洞就一起冒出来。所以临时键合胶要同时满足三点,与硅匹配的 CTE、低固化收缩、以及剥离后零残胶,而这三项不能分开验收。工程上我们通常先量减薄后翘曲的绝对值与方向,再决定是调键合层配方,还是改减薄与搬运顺序。
晶圆在进行 400 °C 以上的高温制程测试时,普通高温胶为什么会失效?
核心原因是高温下的高分子链段断裂与脱气污染。许多耐高温胶标称耐 300 °C,但在 400 °C 的真空或等离子体环境中,高分子链段迅速断裂并释放大量挥发性有机物(VOCs);这些物质冷凝后会污染测试探针与腔体设备,即典型的 Outgassing 异常。此类工况必须选用分子结构经特殊改性的晶圆级特种耐高温胶,并以 ASTM E595 的总质量损失(TML)与可凝挥发物(CVCM)作为量化门槛,峻茂新材料 400-500 °C 系列即针对该温区设计。
散热设计良好的 AI 芯片,为什么在运行半年后温度会突然异常飙高?
最可能的原因是导热层(TIM1)的泵出效应(Pump-out)。液冷冷板带走了顶盖的热量,却同时加剧了硅裸片与顶盖之间的温度梯度。芯片在满载与待机之间高频切换时产生的热胀冷缩,会对 TIM1 施加反复的剪切载荷。若导热胶的聚合物基体与导热粉体结合力不足,成千上万次挤压后胶体会被泵出芯片表面,界面出现空气层,热阻随之飙升。必须改用兼顾 20-40 W/m·K 导热系数与 30 MPa 高剪切强度的高模量 TIM 材料以抵抗泵出,并按 ASTM D5470 在目标压力与粘接层厚度(BLT)下复核热阻。
混合键合(Hybrid Bonding)对界面材料最苛刻的要求是什么?
是亚纳米级的洁净度与表面平坦度。混合键合取消焊料凸点,依靠铜对铜与氧化物对氧化物在原子尺度直接成键,抛光后的介质表面起伏需控制在 0.2 nm 量级,铜焊盘则要略低于介质面几个纳米,靠 200-300 °C 退火时的铜膨胀闭合间隙,对准精度同时进入亚百纳米量级。ECTC 上 imec 与 EV Group 已演示 200 nm 晶圆对晶圆节距、键合后套刻优于 40 nm;应用材料则把节距标杆推到 450 nm,在 2000 万条互连上做到 98% 良率,并把界面处的碳富集薄层与铜晶粒取向指认为纳米级开口缺陷的来源。任何一颗百纳米级颗粒,或临时键合胶残留的有机分子,都会让局部区域无法贴合,退火后膨胀为宏观空洞,直接导致该区域上下层芯片断路。因此临时键合与掩膜材料必须实现无残胶剥离,而残留物的化学身份往往要等到退火之后才以失效形式暴露。
背面供电(BSPDN)工艺为什么对临时键合胶提出更高要求?
背面供电把供电网络从芯片正面移到晶圆背面,工艺链因此新增晶圆对晶圆键合、超薄化减薄、背面对准、纳米级硅通孔(nTSV)刻蚀与背面金属化等多道工序。英特尔在 VLSI 研讨会上给出的量化结果是:PowerVia 把最坏情况下的动态电压跌落压到约 1/10,布线面积压缩 11%,换来最高 6% 的频率提升或超过 15% 的动态功耗下降;台积电 A16 的超级供电轨(SPR)则以背面对源漏的直接接触保住 N2P 的栅极密度,量产窗口已经锁定。晶圆减薄到极薄厚度后刚性急剧下降,必须靠临时键合层提供机械支撑;而背面对准偏差会直接推高接触电阻,甚至造成开路。键合层因此必须在键合、减薄、通孔刻蚀与金属化的全流程中同时满足热稳定性、低脱气、与硅匹配的 CTE,以及剥离后零残胶,任何一项失守都会在良率上成倍放大。
HBM4 世代为什么仍然使用 MR-MUF 而不是混合键合?
约束来自封装总厚度。JEDEC 将 HBM 封装厚度上限从 720 μm 放宽到 775 μm,而标准 300 mm 逻辑晶圆厚度同样是 775 μm,因此内存堆叠不能高出旁边的处理器。SK 海力士在最新一届 Hot Chips 上再次明确混合键合赶不上 HBM4E,最早顺延至 HBM5 世代,期间继续由热压键合(TCB)与批量回流模塑底填(MR-MUF)承担主干工艺;当前 12 层堆叠量产、16 层(48 GB/立方体)进入客户验证,核心裸片压到约 50 μm,层间间隙较 12 层减半,而堆叠热负载已是前几代的 2.2 倍。散热因此部分转由封装内的独立导热结构解决, SK 海力士的 iHBM 在 D2D 物理层嵌入绝缘导热块,官方口径是热阻下降逾三成,三星的 HPB 走的是另一条热通道,两家均计划自 HBM5 起量产。厚度预算放宽后,微凸块方案重新获得余量,而亚纳米洁净度与亚百纳米对准这两项硬约束已经提前写进下一代工艺清单。
CoWoS-L 与面板级封装把封装尺寸放大后,界面材料的选型逻辑发生了什么变化?
封装尺寸放大后,界面数量成倍增加, CTE 失配的累积量也随之放大,翘曲从次要约束升级为一阶约束。台积电的路线可以看清这条曲线:3.5 倍掩膜版的 CoWoS-L 已经量产, 5.5 倍掩膜版完成认证并进入量产, 14 倍掩膜版已在路线图上,可容纳约 10 颗大型计算裸片与 20 个 HBM 堆叠。此时单一材料的低 CTE 已不足以解决问题,需要成对评估 Tg 与 CTE:Tg 再高,只要 CTE 与硅失配,板级热循环下界面仍然先开裂。工程上应以低 CTE 底填分散微凸块承担的剪切应力,以高模量导热界面材料抵抗 TIM1 泵出,并同时核对可迁移离子含量与固化收缩率,避免在放大后的封装体上引入新的应力集中源。
延伸阅读